Introduction
L'intégration de l'intelligence artificielle est devenue un levier de compétitivité. Pourtant, pour les PME évoluant dans des secteurs hautement réglementés comme la santé, la finance ou le juridique, le choix d'une solution d'IA dépasse largement la simple performance technologique. La question de la souveraineté des données IA est devenue centrale, créant un véritable dilemme entre la facilité d'accès aux puissantes API de Cloud AI et l'exigence de conserver un contrôle total sur ses informations les plus sensibles.
Faut-il privilégier la rapidité et l'échelle des services cloud comme OpenAI ou Anthropic, au risque de voir transiter des données critiques hors des juridictions européennes ? Ou investir dans une IA on-premise, auto-hébergée, garantissant une souveraineté totale, mais potentiellement plus lourde à déployer et maintenir ? Ce défi est d'autant plus complexe que des régulations comme le RGPD ou le statut HDS (Hébergeur de Données de Santé) imposent des cadres stricts.
En tant que partenaire CTO et développeur Full Stack, Aetherio accompagne les startups, les PME et les scale-ups dans ces décisions stratégiques, en conciliant innovation technologique et conformité réglementaire. Cet article explorera en détail les enjeux de l'IA on-premise vs cloud pour les PME des secteurs sensibles, vous offrant une feuille de route claire pour garantir la souveraineté de vos données avec l'IA.
Le Dilemme de la Souveraineté : API Cloud VS Modèles Self-Hosted
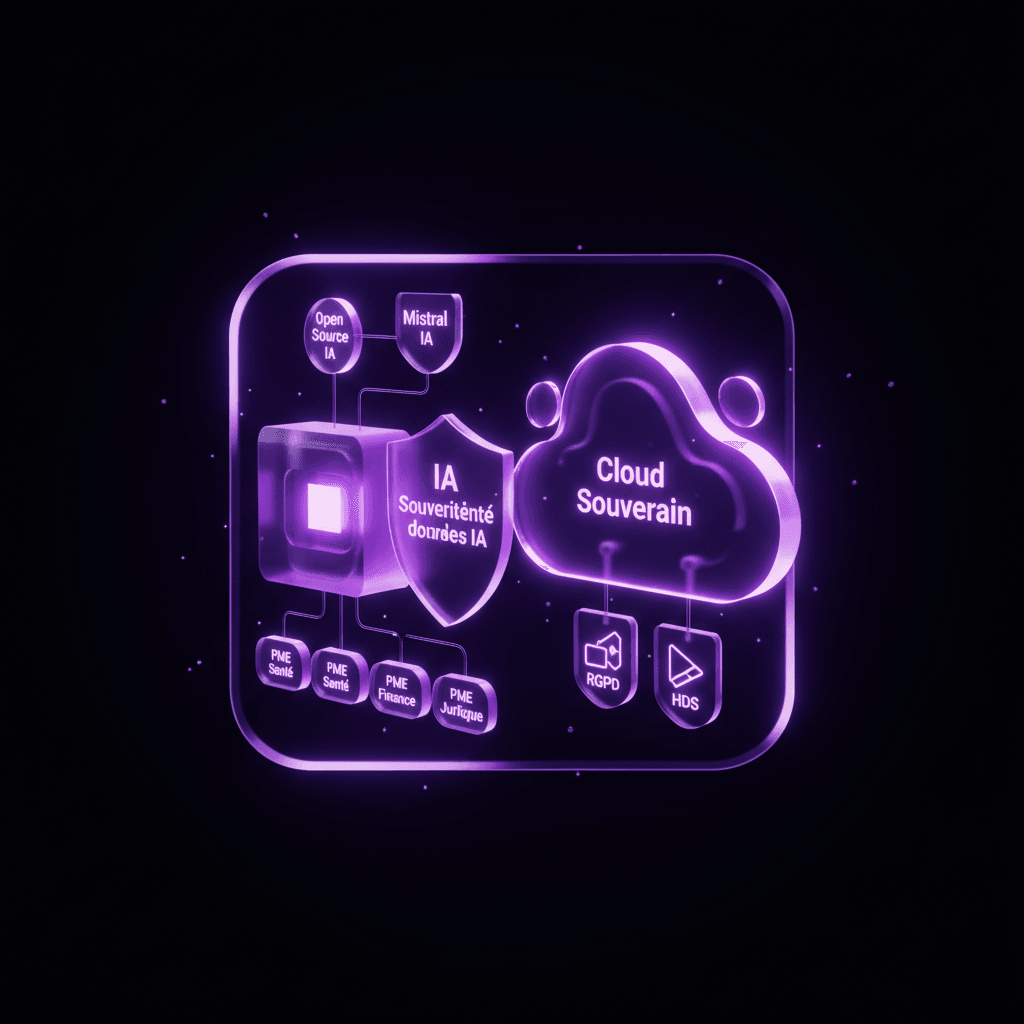
Au cœur de la révolution de l'IA générative, deux approches s'affrontent, chacune avec ses avantages et ses inconvénients majeurs, particulièrement amplifiés dans les contextes de données sensibles. D'un côté, nous avons les modèles d'IA as a Service (AIaaS) proposés par les géants du cloud, de l'autre, la flexibilité et le contrôle des solutions IA on-premise basées sur des LLM (Large Language Model) open source self-hosted.
Les promesses et les pièges des APIs cloud (OpenAI, Anthropic)
Les APIs cloud, telles que celles offertes par OpenAI (ChatGPT API) ou Anthropic (Claude API), représentent une facilité d'intégration et une puissance de calcul inégalées. Elles permettent aux entreprises d'accéder à des modèles de pointe sans l'investissement initial colossal en infrastructure et en compétences. Les avantages sont multiples :
- Déploiement rapide : Quelques lignes de code suffisent pour intégrer des fonctionnalités IA sophistiquées.
- Scalabilité quasi infinie : Les besoins en calcul sont gérés par le fournisseur cloud, s'adaptant dynamiquement à la charge.
- Coûts variables : Paiement à l'usage, ce qui est attractif pour des démarrages de projets.
- Performances de pointe : Accès aux modèles les plus avancés du marché, souvent entraînés sur des bases de données massives.
Cependant, les inconvénients sont significatifs, notamment en matière de souveraineté des données IA. Lorsque vous envoyez vos requêtes et vos données (même si elles sont anonymisées ou pseudonymisées) à ces APIs, elles transitent et sont traitées sur des serveurs dont la localisation est souvent hors de l'Union Européenne (principalement États-Unis). Cela soulève des questions juridiques, éthiques et de compliance :
- Juridiction extra-territoriale : Les données peuvent être soumises aux lois des pays hôtes (ex: Cloud Act américain), donnant accès à des entités étrangères à vos informations.
- Confidentialité : Malgré les engagements de non-réutilisation des données pour l'entraînement, la confiance est de mise et le risque zéro n'existe pas.
- Conformité RGPD : Le transfert de données personnelles hors de l'UE est encadré par des règles strictes, nécessitant des clauses contractuelles types (CCT) ou des mécanismes équivalents, qui sont parfois fragilisés par les décisions de justice (ex: Schrems II).
L'alternative des LLM open source self-hosted : souveraineté à quel prix ?
Face à ces défis, les modèles d'IA open source auto-hébergés (self-hosted) apparaissent comme une solution pour garantir une souveraineté des données IA optimale. Des projets comme Mistral on-premise (en versions locales) ou des LLM open-weight self-hosted (Mistral Large 3, Devstral 2, Llama, etc.) permettent d'exécuter l'IA directement sur votre propre infrastructure. Les bénéfices sont clairs :
- Contrôle total des données : Les données ne quittent jamais votre environnement, garantissant une protection maximale.
- Conformité réglementaire : Idéal pour les secteurs avec des régulations strictes comme le HDS en santé ou les données juridiques sensibles.
- Personnalisation poussée : Possibilité de fine-tuner les modèles avec vos propres données, créant une IA parfaitement adaptée à vos besoins spécifiques.
- Indépendance vis-à-vis des fournisseurs cloud : Réduction du vendor lock-in.
Cependant, cette autonomie a un coût significatif, souvent sous-estimé :
- Complexité de l'infrastructure : Nécessite des serveurs puissants équipés de GPU performants, coûteux à l'achat et à la maintenance.
- Compétences techniques : Expertise requise en MLOps, DevOps, science des données pour le déploiement, l'entraînement, la maintenance et la mise à jour des modèles.
- Coût initial élevé : Investissement important en matériel et en ressources humaines.
- Maintenance et mises à jour : La gestion des modèles, infrastructures et dépendances est une tâche continue et chronophage.
Le choix entre ces deux approches n'est donc pas seulement technique, mais profondément stratégique, impactant la sécurité, la conformité et le modèle économique de l'entreprise.
Tableau Comparatif : IA On-premise vs. Cloud IA
Pour prendre une décision éclairée entre IA on-premise vs cloud, il est essentiel d'analyser les différents paramètres clés en fonction de vos besoins et contraintes spécifiques. Voici un tableau comparatif détaillé, intégrant les perspectives de coûts, de performances, de conformité et de maintenance, éléments cruciaux pour les PME soucieuses de la souveraineté de leurs données avec l'IA.
| Caractéristique | API Cloud (OpenAI, Anthropic, AWS Bedrock) | IA On-premise (LLM open source self-hosted, Mistral on-premise) |
|---|---|---|
| Coût Initial | Très faible (paiement à l'usage) | Très élevé (achat GPU, serveurs, licences logicielles, personnel spécialisé) |
| Coût Opérationnel | Variable (selon utilisation, prévisible) | Élevé (énergie, refroidissement, maintenance matérielle, MLOps, mises à jour) |
| Performance & Scalabilité | Très élevée, évolutive instantanément, accès aux derniers modèles | Potentiellement élevée, mais limitée par l'infrastructure physique, scalabilité complexe |
| Conformité RGPD | Complexe (transferts hors UE), nécessite CCT et diligence raisonnable | Optimale (données restent dans votre juridiction), facile à auditer |
| HDS (Santé) | Uniquement via un service certifié HDS (certaines offres cloud le sont, la plupart des API d'IA non) | Pas de certification requise si l'établissement héberge ses propres données ; obligatoire pour un prestataire qui héberge pour le compte d'un tiers |
| Souveraineté des Données | Limitée (données traitées par tiers), Cloud Act potentiel | Maximale (contrôle total et exclusif des données et modèles) |
| Maintenance & Opérations | Géré par le fournisseur cloud (patchs, mises à jour modèles) | Très élevée (MLOps, sécurité, mises à jour logicielles/matérielles, debugging) |
| Dépendance Fournisseur | Forte dépendance au fournisseur cloud et à son API | Faible dépendance directe, mais requiert une forte expertise interne/externe pour l'implémentation |
| Personnalisation | Fine-tuning possible (avec données envoyées au cloud) | Fine-tuning intégral et sécurisé sur site (données non partagées) |
| Latence | Variable (dépend de la distance serveur, API calls) | Faible (si infrastructure locale et optimisation) |
Le rôle du cloud souverain (AWS Bedrock, OVHcloud AI Platform, Scaleway)
Entre le tout cloud généraliste et le tout on-premise, des solutions de Cloud Souverain IA émergent. Des acteurs comme AWS avec ses régions européennes et des services de type Bedrock, OVHcloud AI Platform ou Scaleway Data Scientist Notebooks proposent des infrastructures localisées en France ou en Europe, avec des garanties de conformité RGPD renforcées. Ces options peuvent être un compromis intéressant, offrant la scalabilité du cloud avec une meilleure garantie de souveraineté pour les données moins critiques qu'une donnée de santé. Attention à la nuance : une région européenne d'un fournisseur américain reste soumise au Cloud Act. Seuls des acteurs de droit européen, ou les offres qualifiées SecNumCloud par l'ANSSI, écartent ce risque. Il faut donc vérifier les conditions précises de chaque offre et la localisation réelle des traitements.
Cas où le Cloud Suffit : Un Compromis pour la Performance et l'Évolutivité
Bien que la tentation d'une IA on-premise pour la souveraineté des données IA soit forte, il existe de nombreux scénarios où l'utilisation d'une infrastructure cloud, même non souveraine au sens strict (c'est-à-dire non française ou européenne, au-delà de la juridiction américaine), reste une solution viable, voire optimale, pour les PME. Ces cas concernent généralement les données moins critiques ou les usages où les garanties contractuelles avec le fournisseur cloud sont jugées suffisantes.
Données non personnelles ou anonymisées
Si les données traitées par l'IA ne contiennent aucune information permettant d'identifier directement ou indirectement une personne (données publiques, statistiques agrégées, données techniques de performance, etc.), l'utilisation d'APIs cloud ne pose généralement pas de problème de souveraineté. L'absence de caractère personnel allège considérablement les contraintes RGPD. Par exemple, l'analyse de tendances de marché à partir de données anonymisées ou la génération de contenu marketing générique.
Données personnelles avec un risque faible et des endpoint UE
Pour certaines données personnelles présentant un risque faible d'atteinte aux droits et libertés des personnes, un compromis peut être trouvé. Si le fournisseur cloud garantit un traitement des données exclusivement sur des serveurs situés dans l'Union Européenne (par exemple, avec les régions européennes d'AWS Bedrock, Google Vertex AI, ou les offres d'Azure AI Services en Europe), les risques liés au transfert hors UE sont réduits, mais pas ceux liés au Cloud Act, qui s'applique à un fournisseur américain quel que soit le lieu de stockage. Il est cependant impératif de s'assurer contractuellement que le traitement reste confiné à l'UE et que le fournisseur ne fait pas appel à des sous-traitants situés hors de l'UE pour cette partie du traitement. Dans ce contexte, la conformité RGPD pour les SaaS est facilitée si le service cloud est lui-même conforme.
Usages non critiques de l'IA
Pour des applications d'IA qui ne touchent pas directement au cœur de métier ou à des données ultra-sensibles, l'efficacité, la vitesse de déploiement et la scalabilité du cloud priment. Il peut s'agir par exemple :
- Traduction automatique de documents internes non confidentiels.
- Génération de code pour des développements non-critiques.
- Analyse de sentiments sur des commentaires publics de clients.
- Aide à la rédaction de communications marketing sans données personnelles.
Dans ces situations, les bénéfices opérationnels liés à l'agilité et au moindre coût initial des solutions cloud l'emportent sur le besoin d'une IA on-premise stricte en termes de souveraineté. Le choix du modèle (voir notre comparatif OpenAI, Claude et Mistral) dépendra alors plus de ses performances que de son mode d'hébergement.
Rester sur une API cloud sans exposer de données personnelles
Entre l'API grand public et le serveur GPU dans vos locaux, beaucoup de PME peuvent rester sur une API cloud, à condition de verrouiller quatre points.
- Le contrat : le fournisseur d'IA agit comme sous-traitant au sens de l'article 28 du RGPD. Il faut un DPA signé, un engagement écrit de ne pas utiliser vos requêtes pour entraîner ses modèles, et la liste de ses propres sous-traitants. Les offres API et entreprise des principaux fournisseurs le prévoient généralement, les abonnements grand public pas toujours : vérifiez-le contrat par contrat.
- La minimisation avant l'appel : une passerelle entre votre application et le LLM retire ou remplace les identifiants directs (nom, e-mail, téléphone, IBAN) par des pseudonymes, et repère ceux que l'utilisateur saisit lui-même dans un champ libre. Le modèle reçoit « le client C-1042 », la correspondance reste dans votre base, et les journaux d'appels suivent la même règle. Des données pseudonymisées restent des données personnelles au sens du RGPD : la passerelle réduit le risque, elle ne sort pas le traitement du champ du règlement.
- L'analyse d'impact : une AIPD est obligatoire dès que le traitement présente un risque élevé (données de santé, profilage à grande échelle, décision automatisée). Si l'IA décide seule avec un effet significatif sur une personne, comme un refus de crédit ou le rejet d'une candidature, l'article 22 du RGPD impose de garantir une intervention humaine et un droit de contestation.
- La classification AI Act : le règlement européen sur l'IA, entré en vigueur en 2024 et applicable par étapes, classe à haut risque les usages en recrutement, en évaluation de solvabilité ou dans certains dispositifs médicaux, avec des obligations de documentation et de contrôle humain. Un simple chatbot relève surtout d'une obligation de transparence : dire à l'utilisateur qu'il échange avec une IA.
Cas où l'On-premise S'impose : La Souveraineté des Données au Cœur de la Stratégie
Si le cloud offre flexibilité et performance pour nombre de cas d'usage, il existe des situations pour les PME où l'IA on-premise n'est pas une option, mais une nécessité absolue pour garantir la souveraineté de leurs données avec l'IA. Ces scénarios sont principalement dictés par des impératifs réglementaires stricts et la nature extrêmement sensible des informations traitées.
Données de Santé (HDS) : La Vigilance Absolue
Le secteur de la santé est sans doute le plus exigeant en matière de protection des données. En France, la certification d'Hébergeur de Données de Santé (HDS) est obligatoire pour tout prestataire qui héberge des données de santé à caractère personnel pour le compte d'un établissement, d'un professionnel ou d'un patient (article L.1111-8 du Code de la santé publique). Ce cadre vise un niveau de sécurité et de confidentialité maximal. Dès qu'une IA traite des dossiers médicaux, des diagnostics ou des informations génétiques, chaque prestataire de la chaîne qui stocke ces données doit donc être certifié HDS.
Dans ce contexte, une IA on-premise devient quasi indispensable. Faire tourner un LLM open-weight (Mistral, par exemple) sur les serveurs de l'établissement, ou chez un hébergeur certifié HDS, est la voie la plus sûre pour une conformité totale. C'est une contrainte à poser dès la conception quand on intègre l'IA dans une application web qui manipule ce type de données.
- Exemple concret : Une clinique qui souhaite développer une IA d'aide au diagnostic à partir des dossiers patients doit impérativement traiter ces données localement ou via un cloud HDS, avec une solution d'IA auto-hébergée (e.g., Mistral on-premise).
Données Juridiques et Financières Ultra-sensibles
Les PME des secteurs juridique et financier manipulent également des données d'une confidentialité extrême : secrets commerciaux, stratégies d'entreprise, portefeuilles clients, données bancaires, informations confidentielles de litiges. Une fuite ou un accès non autorisé à ces informations pourrait avoir des conséquences désastreuses, tant sur le plan financier que réputationnel.
Bien que le RGPD s'applique ici aussi, la sensibilité particulière de ces données justifie souvent une approche d'IA on-premise ou un cloud souverain extrêmement audité. Les risques liés au Cloud Act ou à d'autres interventions gouvernementales étrangères sont intolérables pour ce type d'informations. L'utilisation de LLM open source self-hosted permet aux entreprises de modifier, d'auditer et de contrôler chaque aspect du traitement, offrant une sérénité maximale.
- Exemple concret : Un cabinet d'avocats souhaitant utiliser l'IA générative pour analyser de grands volumes de documents légaux impliqués dans une fusion-acquisition complexe. L'intégrité et la confidentialité des données exigent que le traitement s'effectue sur site ou sur une infrastructure dédiée et entièrement sous contrôle.
Protection de la Propriété Intellectuelle et des Secrets Commerciaux
Pour toute PME dont l'avantage concurrentiel repose sur des algorithmes propriétaires, des données de recherche et développement exclusives, ou des secrets commerciaux, l'IA on-premise est la garante de la protection de ces actifs immatériels. Envoyer ces informations, même de manière transitoire, à un fournisseur cloud, pourrait exposer l'entreprise à des risques de divulgation, de réutilisation ou de perte de contrôle, même infimes. L'architecture SaaS d'une solution interne d'IA serait alors conçue pour isoler complètement ces données.
Dans ces contextes, la décision d'opter pour l'on-premise n'est plus une question de coût ou de complexité, mais une exigence fondamentale de sécurité et de conformité, ancrée dans la stratégie business de l'entreprise.
Le Coût Réel d'une Infrastructure IA On-premise : Au-delà de la Perception
La perception courante est souvent que les solutions IA on-premise sont intrinsèquement plus économiques à long terme car on évite les coûts récurrents du cloud. Cependant, la réalité est plus complexe, et l'investissement dans une infrastructure d'IA on-premise garantissant la souveraineté des données IA pour les PME des secteurs sensibles implique des coûts cachés et des compétences spécifiques qui sont souvent sous-estimés.
1. Le matériel : GPUs et serveurs haute performance
Pour exécuter des LLM de taille similaire à ceux utilisés par OpenAI ou Anthropic, même des modèles open source comme les versions plus larges de Llama ou Falcon, il faut une puissance de calcul colossale. Cela se traduit par l'acquisition de serveurs équipés de GPUs (Graphical Processing Units) de dernière génération, comme le Nvidia A100 ou l'H100, dont le coût peut atteindre des dizaines de milliers d'euros par unité. Une estimation basse pour une ferme de serveurs capable de gérer des charges de travail d'IA significatives peut s'élever à 100 000 € à 500 000 €, sans compter les coûts liés à l'alimentation électrique, au refroidissement et à la maintenance physique.
2. Le MLOps et l'expertise technique
Déployer et maintenir un modèle d'IA auto-hébergé ne se limite pas à l'achat de matériel. Cela requiert des compétences en MLOps (Machine Learning Operations). Il s'agit d'un ensemble de pratiques pour déployer et maintenir des modèles de Machine Learning en production de manière fiable et efficace. Cela inclut :
- Déploiement et orchestration : Utilisation de technologies comme Docker et Kubernetes pour encapsuler et gérer les modèles.
- Surveillance et journalisation : Mise en place de systèmes de monitoring pour suivre les performances du modèle et détecter les dérives (dérive de données, de modèle).
- Mises à jour et ré-entraînement : Processus automatisé pour mettre à jour les modèles avec de nouvelles données, assurant leur pertinence.
- Sécurité : Renforcement des systèmes pour protéger les données et les modèles contre les cyberattaques.
- Ingénieurs ML/DevOps : Le recrutement ou la formation de ces profils est coûteux, avec des salaires annuels souvent supérieurs à 70 000 € pour des profils expérimentés en France.
3. La maintenance et les mises à jour logicielles
Les LLM et les cadres d'IA (PyTorch, TensorFlow) évoluent très rapidement. Une solution on-premise exige une veille technologique constante et des efforts significatifs pour maintenir les logiciels à jour, appliquer les patchs de sécurité et prévenir la dégradation des performances. Cela implique des coûts récurrents en ressources humaines et potentiellement en licences logicielles pour certains outils.
4. La bande passante et la connectivité réseau
Même si l'IA est on-premise, les modèles nécessitent souvent l'accès à de grandes quantités de données pour l'entraînement ou pour obtenir des ressources externes (packages, mises à jour). Une bande passante suffisante et une connectivité réseau robuste sont cruciales et peuvent représenter un coût significatif, surtout pour les PME en dehors des grandes métropoles.
5. Les coûts indirects et les risques
- Temps de mise sur le marché : Le déploiement d'une IA on-premise est souvent plus long que l'intégration d'une API cloud.
- Obsolescence : Les GPUs vieillissent, les technologies évoluent. L'investissement initial risque de s'obsoléter plus rapidement que prévu.
- Risque d'échec : Sans l'expertise adéquate, le projet d'IA self-hosted peut échouer ou sous-performer, gaspillant l'investissement.
En fin de compte, l'illusion d'un coût nul après l'investissement initial est trompeuse. Les coûts cachés (MLOps, recrutement, maintenance, énergie) peuvent rapidement dépasser les frais d'abonnement cloud, surtout pour des PME qui n'ont pas les ressources internes. C'est ici qu'un partenariat stratégique avec des experts en développement d'applications sur-mesure et IA comme Aetherio prend tout son sens, pour évaluer ces coûts et construire une stratégie d'IA réaliste et pérenne.
Conclusion
Le choix entre une IA on-premise vs cloud pour les PME des secteurs réglementés (santé, finance, juridique) ne se résume pas à une simple préférence technologique. C'est une décision stratégique majeure, directement liée à la souveraineté des données IA et à la conformité réglementaire (RGPD, HDS). Tandis que les APIs cloud offrent une agilité et une puissance inégalées pour les données moins critiques, l'IA on-premise avec des LLM open source self-hosted comme Mistral on-premise devient une exigence impérieuse dès que des informations ultra-sensibles sont en jeu.
Ce qu'il faut retenir pour votre PME :
- Évaluez la criticité de vos données : Les données de santé (HDS) et les informations juridiques/financières ultra-sensibles exigeront probablement une solution IA on-premise pour garantir la souveraineté des données IA.
- Considérez les compromis du cloud souverain : Des offres comme AWS Bedrock en région européenne peuvent offrir un équilibre entre scalabilité et conformité pour des données personnelles à risque modéré.
- Anticipez les coûts réels de l'on-premise : L'acquisition de GPUs, le recrutement de profils MLOps, et la maintenance continue représentent des investissements significatifs au-delà du coût initial perçu.
- La conformité RGPD est non négociable : Que vous soyez dans le cloud ou en on-premise, votre stratégie d'IA doit être blindée contre les risques de fuites ou d'utilisation abusive de données personnelles.
Chez Aetherio, nous développons des applications sur mesure et intégrons l'IA dans des applications web en partant de ces contraintes : nous évaluons la criticité de vos données, auditons vos besoins et concevons une architecture conforme à vos exigences de souveraineté.
Vous avez des données sensibles et souhaitez intégrer l'IA en toute sécurité ?Parlons de votre projet : un audit de vos données et de vos contraintes suffit pour trancher entre cloud, cloud souverain et on-premise.
Lectures complémentaires :
- Protection des données SaaS : obligations RGPD
- OpenAI vs Claude vs Mistral : quel LLM choisir pour votre application
- RAG en entreprise : connecter l'IA à vos données internes